
작업 흐름
복사되지 않는 PDF에서 텍스트 복사하기
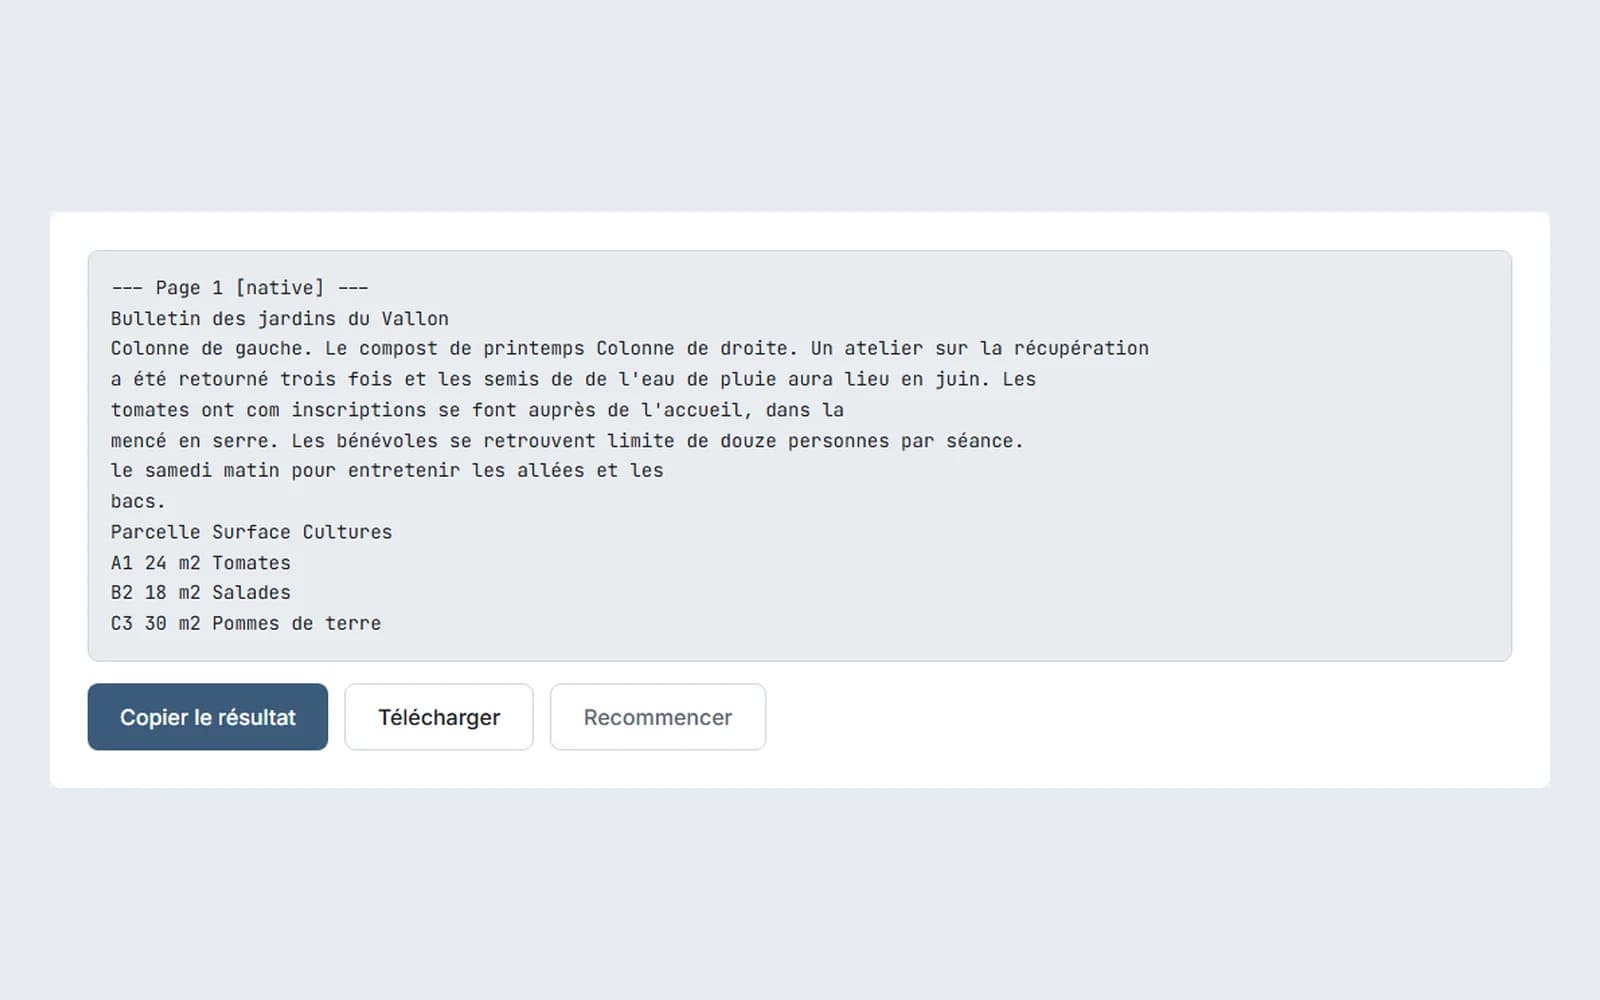
진짜 텍스트인가, 텍스트 이미지인가. PDF를 텍스트로가 되살리는 것, 여러 단과 끊어진 단어에서 놓치는 것, 스캔을 다루는 방식.
업데이트 2026년 9월 14일 · 읽는 데 1분
PDF에 저장된 텍스트를 그대로 추출합니다. 열, 표, 머리글 같은 레이아웃은 유지되지 않습니다. 줄바꿈이 다소 어색한 일반 텍스트가 나올 수 있습니다.
무료, 계정 불필요, 브라우저 처리, 서버 업로드 없음.
파일 업로드 — PDF를 텍스트로
파일을 여기에 끌어다 놓으세요 · 기기에서 파일 선택
Max 100 Mo
PDF에 저장된 텍스트를 그대로 추출합니다. 열, 표, 머리글 같은 레이아웃은 유지되지 않습니다. 줄바꿈이 다소 어색한 일반 텍스트가 나올 수 있습니다.
원본 텍스트 레이어는 유지됩니다. 스캔된 페이지는 브라우저에서 OCR로 로컬 처리하고, 혼합 PDF는 페이지별로 처리합니다. 현재 OCR은 프랑스어에 최적화되어 있어 다른 언어에서는 정확도가 낮을 수 있습니다. 제목, 표, 이미지는 원본 레이아웃대로 정확히 재구성되지 않으므로 결과를 확인하세요.
작업 흐름
진짜 텍스트인가, 텍스트 이미지인가. PDF를 텍스트로가 되살리는 것, 여러 단과 끊어진 단어에서 놓치는 것, 스캔을 다루는 방식.
업데이트 2026년 9월 14일 · 읽는 데 1분
작업 흐름
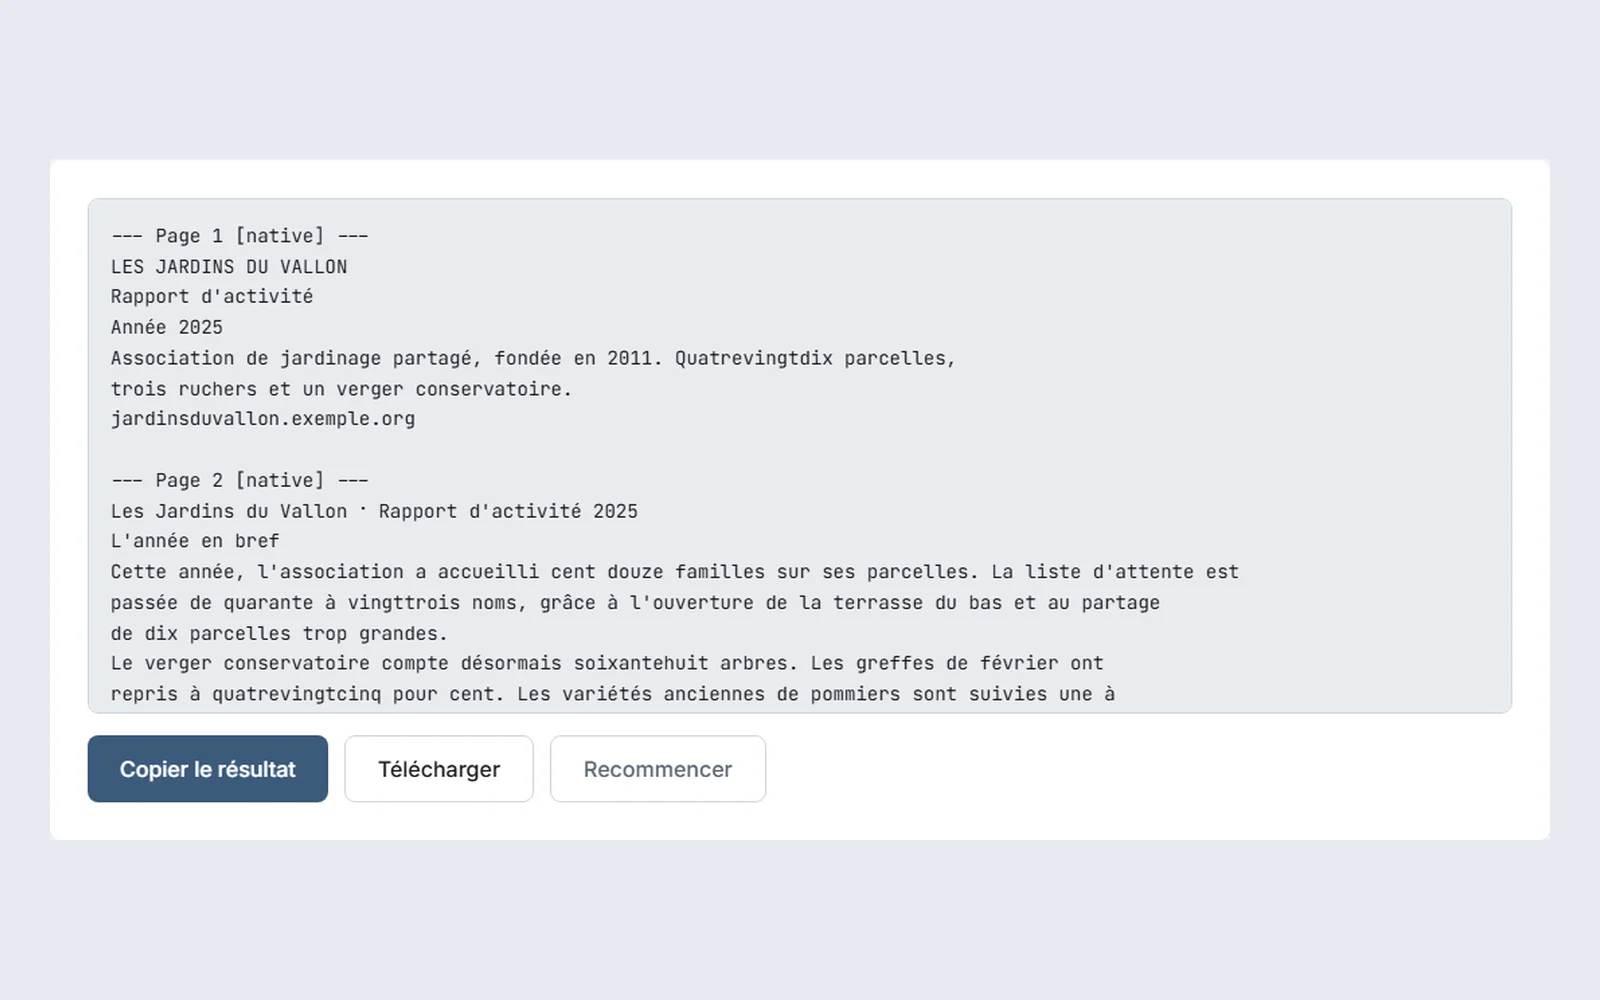
텍스트, 문서의 일부, 페이지 이미지. PDF에서 찾는 것을 얻으려면 어떤 도구를 골라야 하고, 각 경우에 무엇을 받는지.
업데이트 2026년 9월 9일 · 읽는 데 1분