
কাজের ধারা
কপি করা যায় না এমন PDF থেকে টেক্সট কপি করা
আসল টেক্সট না টেক্সটের ছবি: PDF থেকে টেক্সট কী উদ্ধার করে, কলাম ও ভাঙা শব্দে কী হারায়, আর স্ক্যানের ক্ষেত্রে কী করে।
হালনাগাদ: ১৪ সেপ্টেম্বর, ২০২৬ · 1 মিনিটের পাঠ
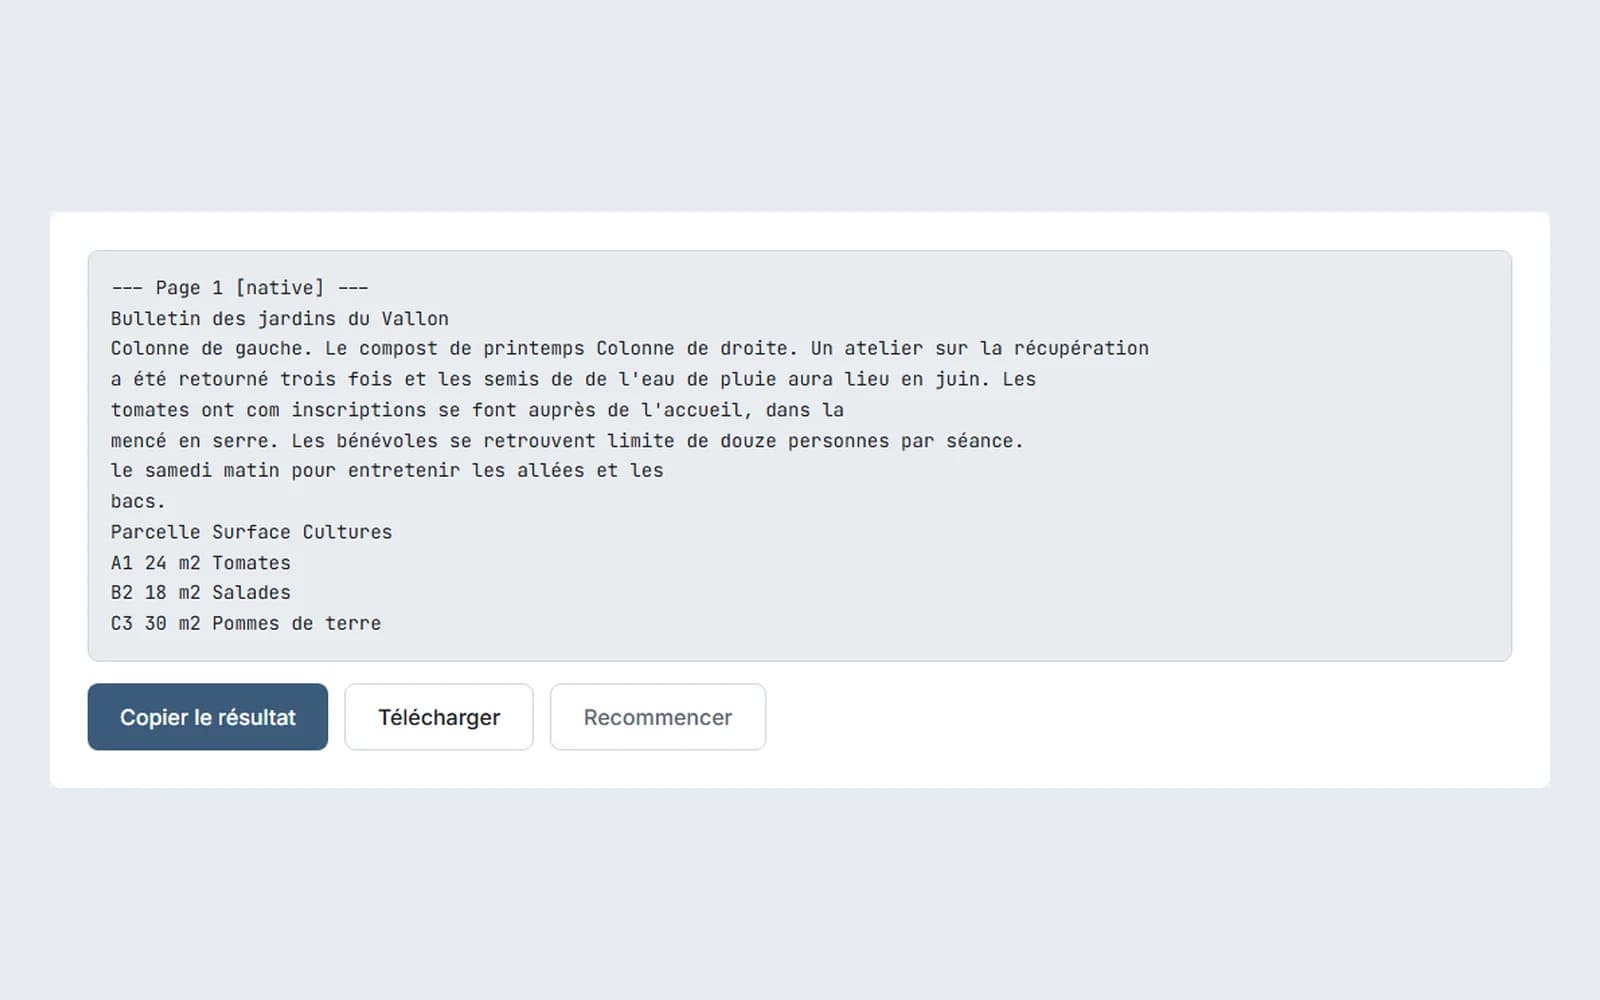
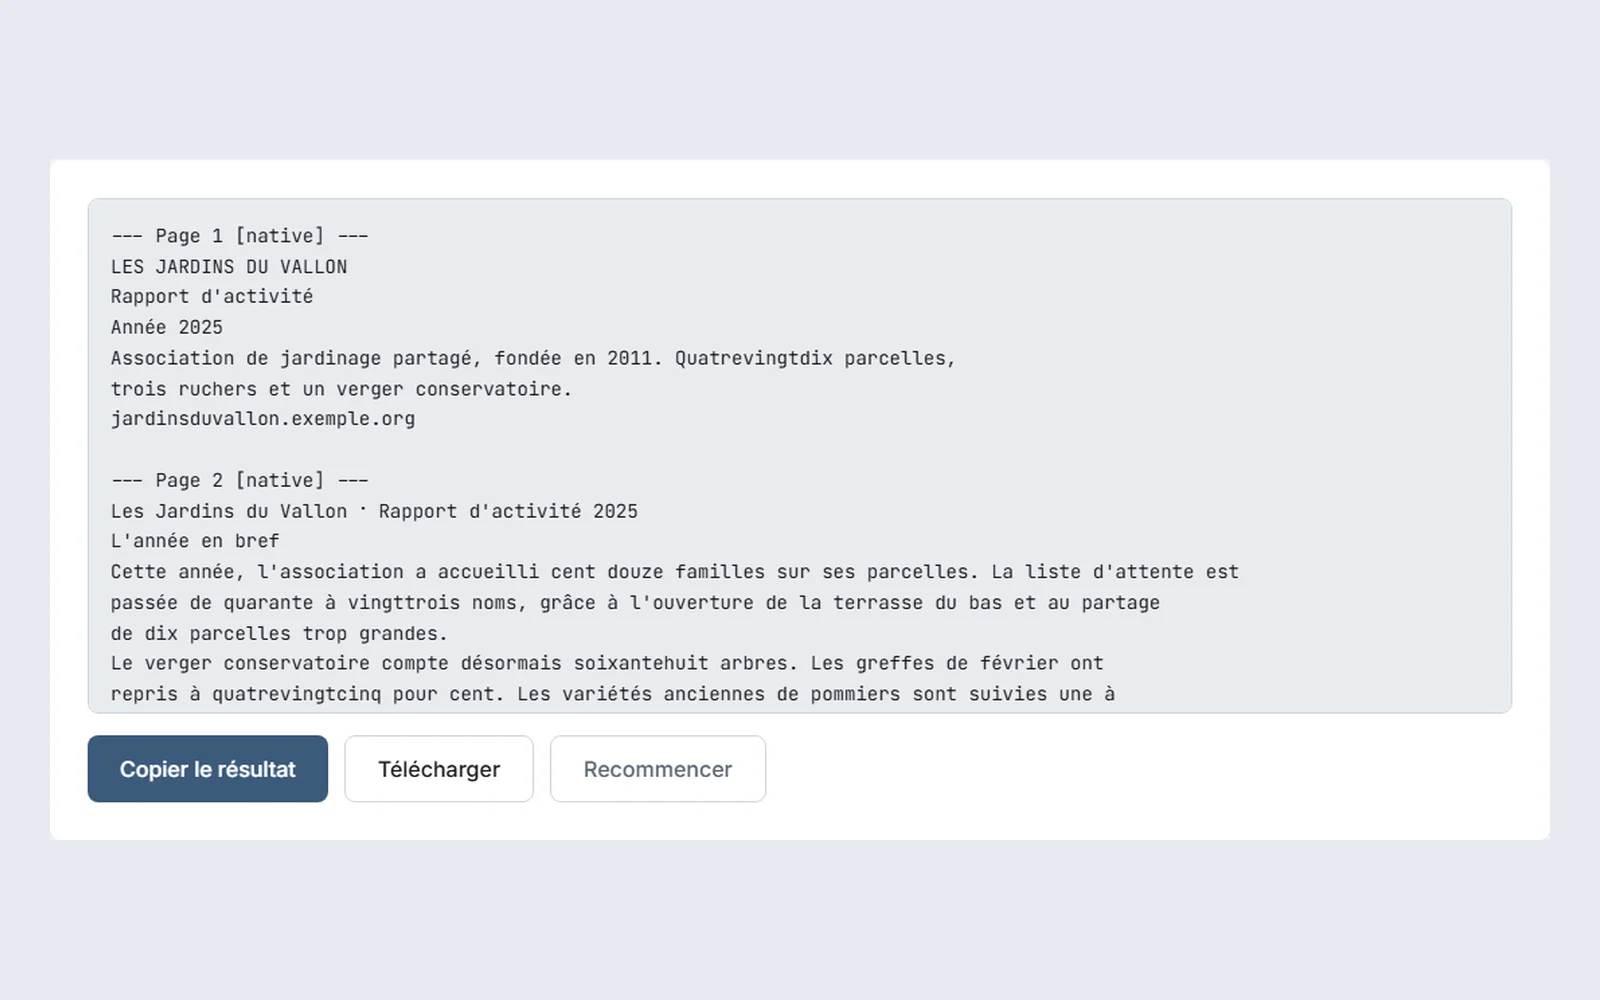
PDF-এ যেভাবে লেখা সংরক্ষিত আছে সেভাবেই তা বের হয়। কলাম, টেবিল ও হেডারের বিন্যাস থাকে না, তাই সাধারণ লেখায় অস্বাভাবিক লাইন ভাঙা দেখা যেতে পারে।
বিনামূল্যে, অ্যাকাউন্ট ছাড়া, ব্রাউজারে প্রক্রিয়া এবং সার্ভারে আপলোড নয়।
ফাইল ছাড়ুন — PDF থেকে টেক্সট
আপনার ফাইল এখানে টেনে আনুন · আপনার ডিভাইস থেকে ফাইল বেছে নিন
Max 100 Mo
PDF-এ যেভাবে লেখা সংরক্ষিত আছে সেভাবেই তা বের হয়। কলাম, টেবিল ও হেডারের বিন্যাস থাকে না, তাই সাধারণ লেখায় অস্বাভাবিক লাইন ভাঙা দেখা যেতে পারে।
মূল টেক্সট স্তর সংরক্ষিত থাকে। স্ক্যান করা পৃষ্ঠাগুলি ব্রাউজারে স্থানীয় OCR দিয়ে প্রক্রিয়া করা হয় এবং মিশ্র PDF পৃষ্ঠা ধরে ধরে প্রক্রিয়া করা হয়। OCR বর্তমানে ফরাসি ভাষার জন্য অপ্টিমাইজ করা, তাই অন্য ভাষায় নির্ভুলতা কম হতে পারে। শিরোনাম, টেবিল ও ছবি হুবহু পুনর্গঠিত হয় না; ফলাফল পরীক্ষা করুন।
কাজের ধারা
আসল টেক্সট না টেক্সটের ছবি: PDF থেকে টেক্সট কী উদ্ধার করে, কলাম ও ভাঙা শব্দে কী হারায়, আর স্ক্যানের ক্ষেত্রে কী করে।
হালনাগাদ: ১৪ সেপ্টেম্বর, ২০২৬ · 1 মিনিটের পাঠ
কাজের ধারা
টেক্সট, নথির একটি অংশ বা পৃষ্ঠার ছবি: PDF-এ যা খুঁজছেন তা পেতে কোন টুল বেছে নেবেন, আর প্রতিটি ক্ষেত্রে কী পাবেন।
হালনাগাদ: ৯ সেপ্টেম্বর, ২০২৬ · 1 মিনিটের পাঠ