
कार्य-प्रवाह
ऐसे PDF का टेक्स्ट कॉपी करें जो कॉपी नहीं होने देता
असली टेक्स्ट या टेक्स्ट की छवि: PDF से टेक्स्ट क्या निकालता है, स्तंभों और टूटे शब्दों में क्या छूट जाता है और स्कैन के साथ क्या करता है।
अद्यतन: 14 सितंबर 2026 · 1 मिनट का पाठ
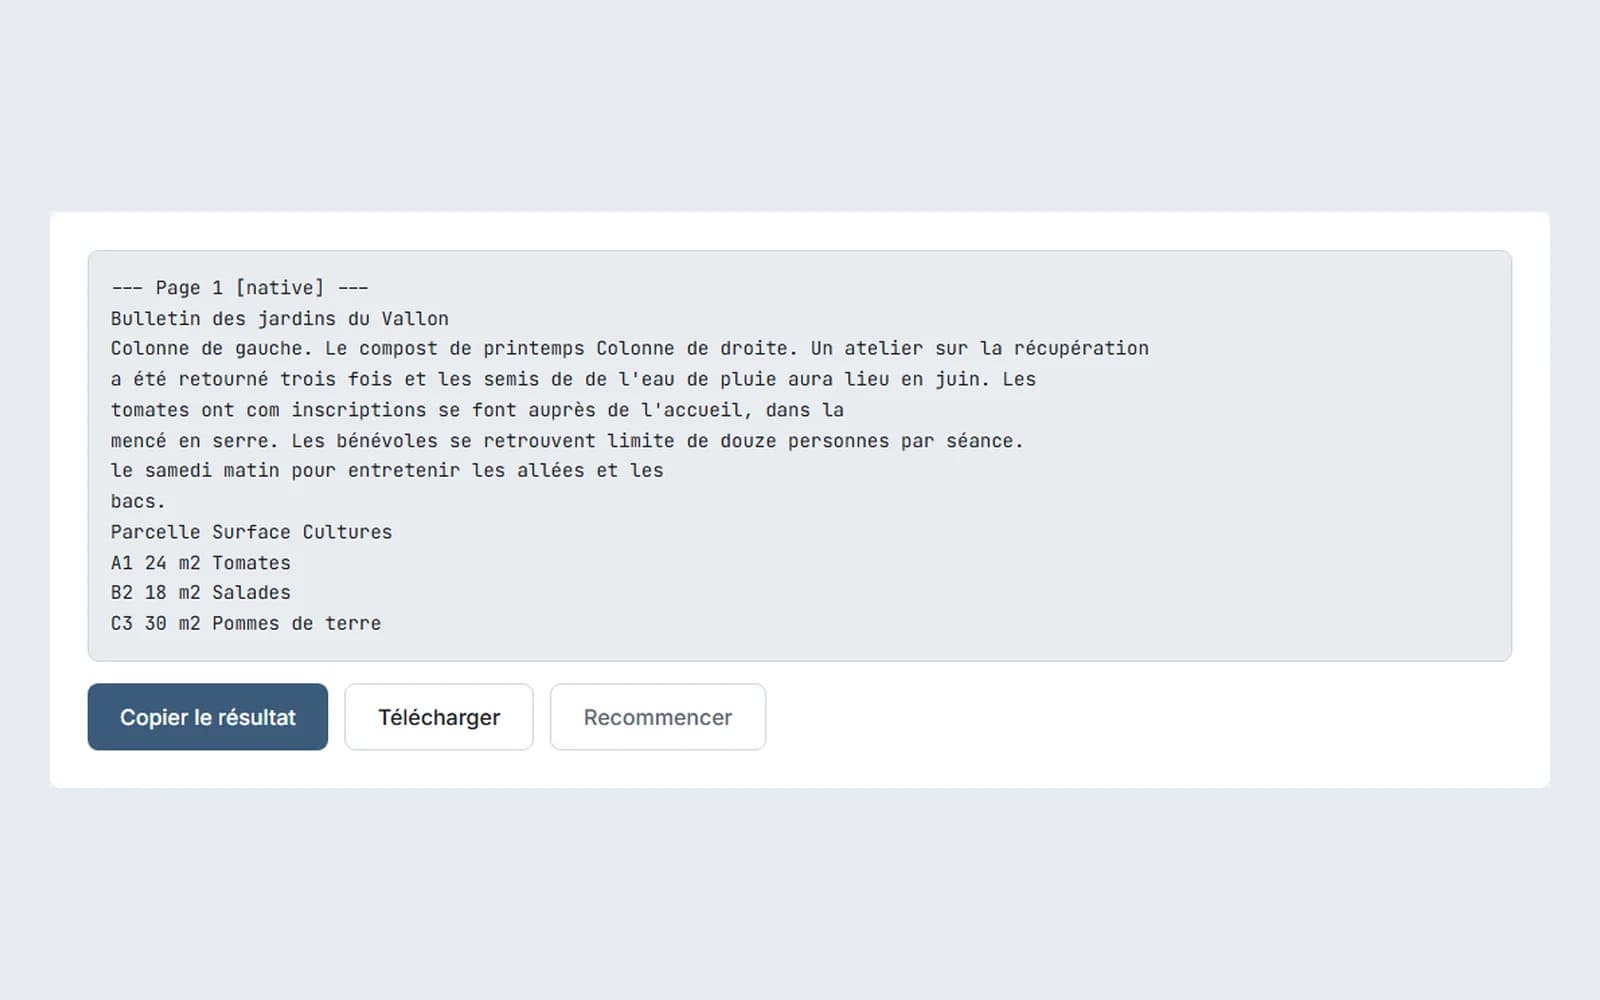
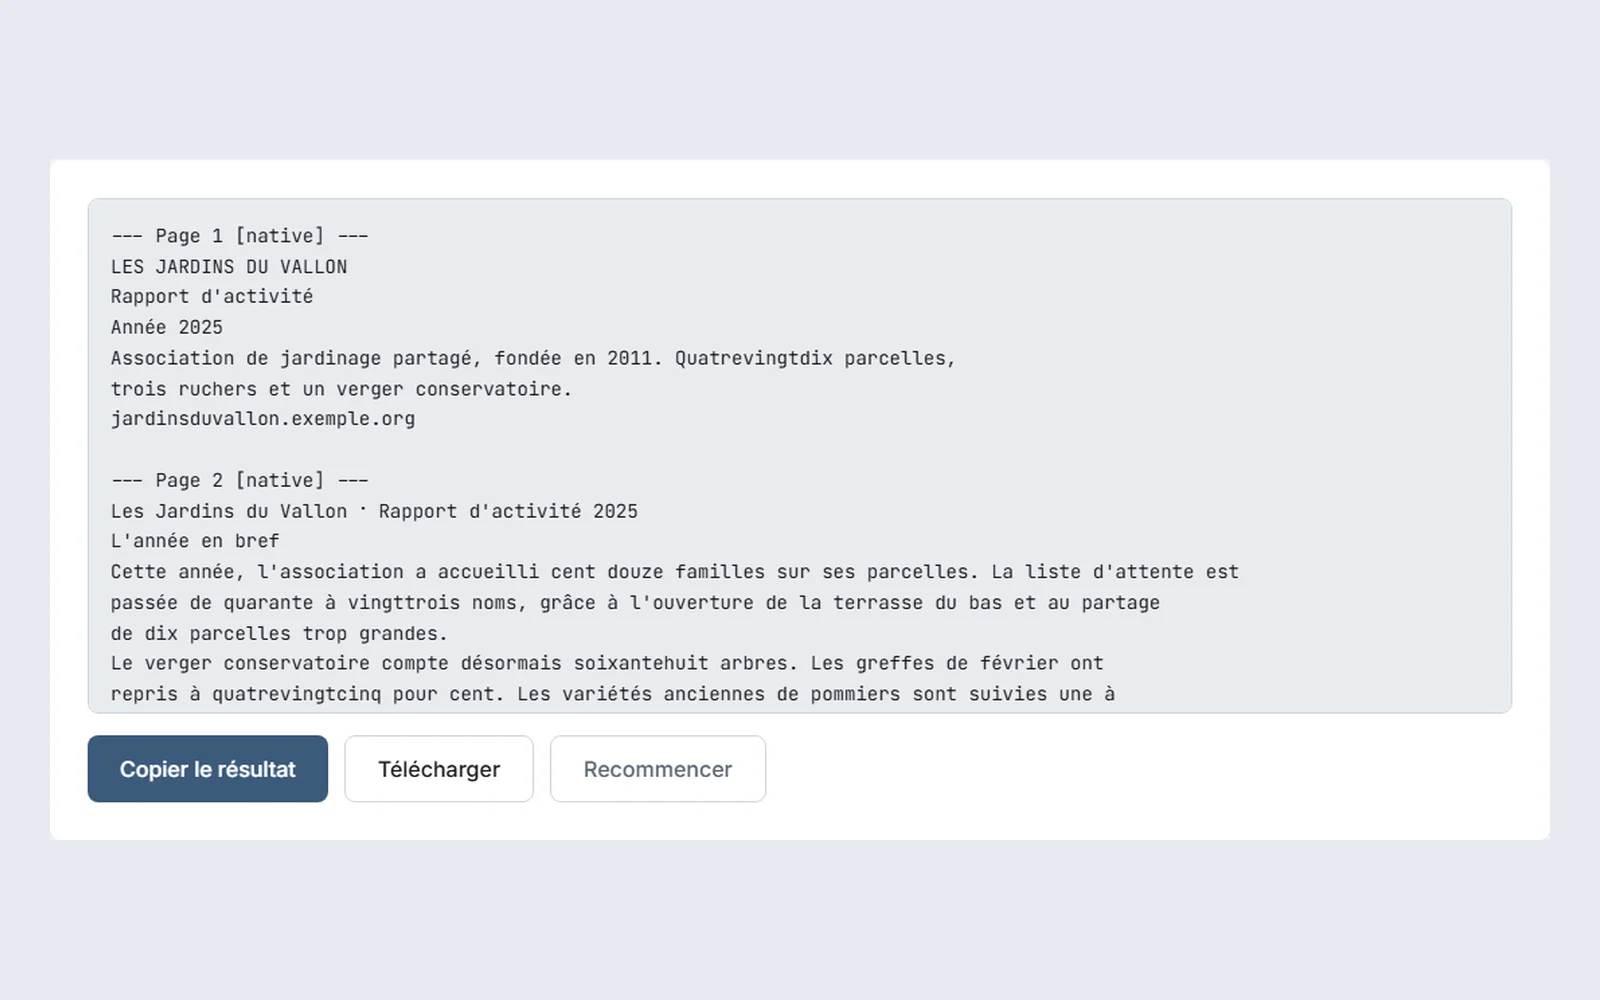
टेक्स्ट उसी रूप में निकाला जाता है जिसमें वह PDF के भीतर रखा है। कॉलम, तालिकाएँ और हेडर जैसे लेआउट सुरक्षित नहीं रहते; परिणाम साधारण टेक्स्ट होता है जिसमें कभी-कभी असामान्य पंक्ति-विराम हो सकते हैं।
मुफ़्त, बिना खाते के, ब्राउज़र में प्रसंस्करण और सर्वर पर अपलोड नहीं।
फाइल छोड़ें — PDF से टेक्स्ट
अपनी फाइल यहाँ खींचकर छोड़ें · अपने डिवाइस से फाइल चुनें
Max 100 Mo
टेक्स्ट उसी रूप में निकाला जाता है जिसमें वह PDF के भीतर रखा है। कॉलम, तालिकाएँ और हेडर जैसे लेआउट सुरक्षित नहीं रहते; परिणाम साधारण टेक्स्ट होता है जिसमें कभी-कभी असामान्य पंक्ति-विराम हो सकते हैं।
मूल टेक्स्ट लेयर सुरक्षित रहती हैं। स्कैन किए गए पृष्ठों को ब्राउज़र में स्थानीय OCR से संसाधित किया जाता है और मिश्रित PDF को पृष्ठ-दर-पृष्ठ संभाला जाता है। OCR अभी फ़्रेंच के लिए अनुकूलित है, इसलिए दूसरी भाषाओं में सटीकता कम हो सकती है। शीर्षक, तालिकाएँ और चित्र मूल रूप में विश्वसनीय ढंग से पुनर्निर्मित नहीं होते; परिणाम जाँचें।
कार्य-प्रवाह
असली टेक्स्ट या टेक्स्ट की छवि: PDF से टेक्स्ट क्या निकालता है, स्तंभों और टूटे शब्दों में क्या छूट जाता है और स्कैन के साथ क्या करता है।
अद्यतन: 14 सितंबर 2026 · 1 मिनट का पाठ
कार्य-प्रवाह
टेक्स्ट, दस्तावेज़ का एक हिस्सा या पृष्ठ की छवि: PDF में जो आप ढूँढ रहे हैं उसे पाने के लिए कौन-सा टूल चुनें, और हर मामले में आपको क्या मिलता है।
अद्यतन: 9 सितंबर 2026 · 1 मिनट का पाठ